
«Компьютерную эпоху видно везде, кроме статистики производительности».
— Роберт Солоу, экономист, 1987
Ну что, все мы уже плотно сидим во всех этих наших Клодах и прочих ЧатЖПТ, а некоторые даже в каком-нибудь Jeff или Z.ai. Нейросеть за минуты делает то, на что раньше уходил вечер: резюме интервью, сводку по выгрузке, черновик слайдов. А срок проекта остаётся прежним. И оказываетя, что дело не в модели. Скорость генерации текста — не скорость проекта: проект идёт со скоростью самого медленного шага, а это почти никогда не «написать». Я решил посмотреть на на пять ложных ускорений, места, где ИИ действительно сокращает проект, и решения, которые нельзя отдавать модели.
Вот типичная история: Третий день диагностики, вечер. Двенадцать интервью расшифрованы, нейросеть за несколько минут сделала резюме каждого и свела проблемы в таблицу. Выгрузка простоев разложена по Парето, есть черновик слайдов к промежуточной встрече. И кажется, что неделю работы закрыли за вечер.
С утра выясняется, что механик в интервью говорил одно, журнал смены показывает другое, а в резюме противоречия нет — оно сгладилось. Откуда цифра на третьем слайде, из какой версии выгрузки, быстро не сказать. (раньше можно было позвать коллегу, который работал над цифрой и совместно установить логику появления цифры, теперь это чаще черный ящик) Коллега работал в своём чате со своими документами, и его выводы с вашими не сходятся. К пятнице проект может быть там же, где был бы без нейросети. Только устали сильнее.
Пока у меня не так много таких примеров, но уже сейчас бывает так, что консультант уже несколько часов мучает нейросетку и пытается выявить весь ли контекст она понимает и не упускает ли важных выводов, но это не всегда так очевидно. В результате — на финальную презентацию команда выходит с классной исторей, но с ощущением, что возможно, слона в комнате они просмотрели (так было в моей практики, когда один клиент вскользь упомянул о наличии второго источника данных, который противоречил первому, а нейросетка просто слила оба источника в один, что привело к ошибке в выводах.
Фразу из эпиграфа Роберт Солоу написал в 1987 году: компьютеры уже стояли в офисах, а статистика производительности этого не замечала. Это назвали парадоксом производительности. Из объяснений мне ближе самое скучное: технология даёт эффект, когда под неё перестроили работу, а не когда её купили.
Пять ложных ускорений
Возьмём условную диагностику, к ней я буду возвращаться. Две недели, два консультанта, производственная площадка. Задача — понять, почему растут внеплановые простои, и принести директору гипотезы причин и план действий. На входе: двенадцать интервью, выгрузка простоев за полгода, регламенты ТОиР, заметки и фото с обхода, отчёт по KPI. Пример собирательный, а не про конкретного клиента.
1. Резюме вместо понимания
Ценность интервью редко в «основных темах» — их опытный консультант часто угадывает ещё до первой встречи. Ценность в деталях и противоречиях: начальник смены винит запчасти, механик — то, что его зовут, когда станок уже стоит. Хорошее резюме такие вещи сглаживает, это его работа. Выросла скорость чтения, а не скорость понимания.
2. Слайды раньше вывода
Черновик презентации можно получить раньше, чем появился вывод. Красивая структура создаёт ощущение готовности, и команда полирует слайды вместо проверки гипотез. В посте про А3 я писал: сгенерированный лист без думания — тот же красивый слайд для начальства, только изготовленный быстрее.
3. Новый чат на каждую задачу
Каждый ведёт свои диалоги со своими версиями файлов и заново объясняет модели, кто есть кто у клиента. По отдельности все работают быстрее. Но вечером начинается сверка: какие документы ты ей давал, знает ли она про вчерашнее интервью, почему у тебя другой вывод. В разборе диагностики без аналитиков я описывал эту ловушку так: ускорили индивидуальную работу, но увеличили расходы на синхронизацию.
4. Быстрый ответ, медленная проверка
Модель отвечает гладко и уверенно, в том числе когда ошибается. Время не исчезает — оно переезжает из написания в проверку. А без ссылки на источник — интервью, строку выгрузки, пункт регламента — проверка обходится дороже, чем написать самому. В нашем примере модель уверенно пишет «главная причина простоев — износ подшипников», а в выгрузке у заметной части записей поле причины пустое.
5. Ускорение не того шага
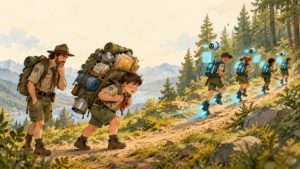
Я уже вспоминал «Цель» Голдратта в записи про OEE бизнеса. В книге есть эпизод ровно про это. Директор завода Алекс Рого ведёт отряд скаутов в поход, и колонна растягивается. Её скорость задаёт самый медленный мальчик, Херби. Подгоняйте тех, кто впереди, сколько угодно — к месту ночёвки отряд придёт тогда, когда придёт Херби. В итоге Алекс ставит Херби во главу колонны и разгружает его рюкзак.
В консалтинговом проекте Херби почти никогда не набор текста. Это выгрузка от ИТ клиента, согласование интервью, доступ на площадку, встреча, где директор должен принять решение. Нейросеть ускоряет тех, кто и так шёл впереди. В «Цели» час, сэкономленный не на узком месте, так и назван — миражом.
Где на самом деле идёт время
Как мы обычно делаем диагностику: Вот поток диагностики по шагам:
- Гипотезы и план диагностики.
- Сбор фактов: интервью, данные, обход площадки.
- Анализ и проверка гипотез.
- Выводы, управленческая история, материалы.
- Решение клиента.
Быстрое письмо ускоряет только черновики первого и четвёртого шагов: гипотезы, план, историю, слайды. Второй и пятый держатся на людях, доступах и решениях клиента — быстрым письмом их не сократить. А третий с ИИ может даже удлиниться: проверять приходится больше.
Как правило самый сложный шаг в диагностике — приоритизация. Что является действительно важным, а что второстепенным? Стоит ли хвататься за решение и снижение себестоимости или стоит обратить внимание на то, что в операционной команде конфликт и без его разрешения ничего вообще не поедет? Тут нейросетка вряд ли сможет помочь. Нужен опыт, серия «перекрестных» вопросов менеджменту. Тут и нужен эксперт
Нейросеть сокращает часы консультанта. Срок проекта она сокращает, только если эти часы стояли на критическом пути.
Где ИИ действительно сокращает проект
Эффект даёт не скорость письма, а то, как ИИ меняет второй, третий и пятый шаги: укорачивает цикл «факт → гипотеза → проверка» или снимает ожидание. В нашем примере я искал бы его в четырёх местах.
Между интервью, а не после них. Вечером после первых встреч модель ищет, где осталась логическая дыра и где ответы двух руководителей противоречат друг другу, и готовит вопросы на завтра. Так ИИ помогал нам на диагностике без аналитиков. Следующие интервью тогда закрывают пробелы, а не повторяют первые.
Первичная работа с данными. Очистка выгрузки, Парето, аномалии по сменам — первая версия за вечер. Но с проверкой данных и формул: пустое поле причины модель может и не заметить, если о нём не спросить.
Общая память проекта. Один контекст на команду: факты, интервью, гипотезы, решения, открытые вопросы. Модели больше не объясняют всё заново, а сверки становится меньше — если договориться, что и как попадает в память.
Подготовка к решению клиента. Если Херби — решение директора, ИИ его не ускорит, но поможет прийти с одной страницей: что знаем, чего не знаем, какое решение нужно сегодня. Тогда встреча чаще заканчивается решением, а не просьбой «доработать».
Что это меняет в нашем примере. К вечеру третьего дня у команды не двенадцать гладких резюме, а реестр противоречий, вопросы на завтрашний обход и таблица фактов, где у каждой строки есть источник. Слайдов ещё нет, и это нормально. Зато на промежуточной встрече с директором есть о чём принимать решение: куда копать дальше.
Что нельзя отдавать модели
Есть решения, которые остаются за человеком при любой модели.
- Какую проблему решаем. Рамка проекта — договорённость с клиентом, а не удачная формулировка.
- Что считать фактом. Модель не была на площадке. Если вы тоже не были — на слайде красиво оформленная пустота.
- Причинность. Модель предлагает гипотезы причин, но не подтверждает их. Подтверждают данные, наблюдение и процессная команда.
- Что и как сказать клиенту. Убедить директора завода модель пока не умеет.
- Ответственность за вывод. Подпись под отчётом остаётся вашей.
Риски и ограничения
- Уверенная ерунда. Модель ошибается гладко, и такую ошибку легче пропустить, чем в черновике стажёра. Поэтому у каждой цифры в клиентском материале — источник.
- Конфиденциальность. Какие данные отдавать модели — договорённость с клиентом, а не настройка сервиса. Только обезличенные, только с разрешения и зная, куда они уходят.
- Нужна опора. ИИ усиливает того, кто умеет делать работу руками: кто ни разу не строил анализ сам, вряд ли увидит, где машина ошиблась.
Модель AI-native консультанта
AI-native консультант — не тот, кто много сидит в чате, а тот, у кого вокруг ИИ перестроен способ работы. Это цикл:
- Контекст проекта живёт в одном месте, а не в двадцати чатах.
- Задача модели ставится как задача стажёру: роль, входные данные, рамка, формат, критерий качества.
- Каждый результат проходит проверку: факты, расчёты, логика, контекст клиента, реализуемость.
- Проверенное возвращается в память проекта, и следующий цикл начинается не с нуля.
- Освободившееся время уходит на Херби: площадку, людей, решения клиента.
Последний пункт главный. Без него первые четыре дают аккуратную работу — и прежний срок проекта.
Короткая самопроверка по последнему проекту:
- Какой шаг был вашим Херби — и ускорил ли его ИИ хотя бы на день?
- Сколько раз вы объясняли модели контекст проекта заново?
- Сможете ли вы за минуту показать, откуда взялась любая цифра на слайде?
Если на первый вопрос ответ «нет» — ИИ у вас пока ускоряет текст, а не проект. А «каждый раз» и «не уверен» — признак, что он ещё и добавляет сверку.